Clúster Energías Alternas
por Kalev Pineda ·
Resumen
El Laboratorio de Energías Alternas necesita simular materiales a nivel atómico: predecir propiedades de celdas solares, electrodos de baterías, catalizadores o recubrimientos antes de sintetizarlos. Esos cálculos de primeros principios (teoría del funcional de la densidad, DFT) consumen horas de procesador y no caben en una laptop. Tampoco es razonable que dependan de horas compradas en centros externos.
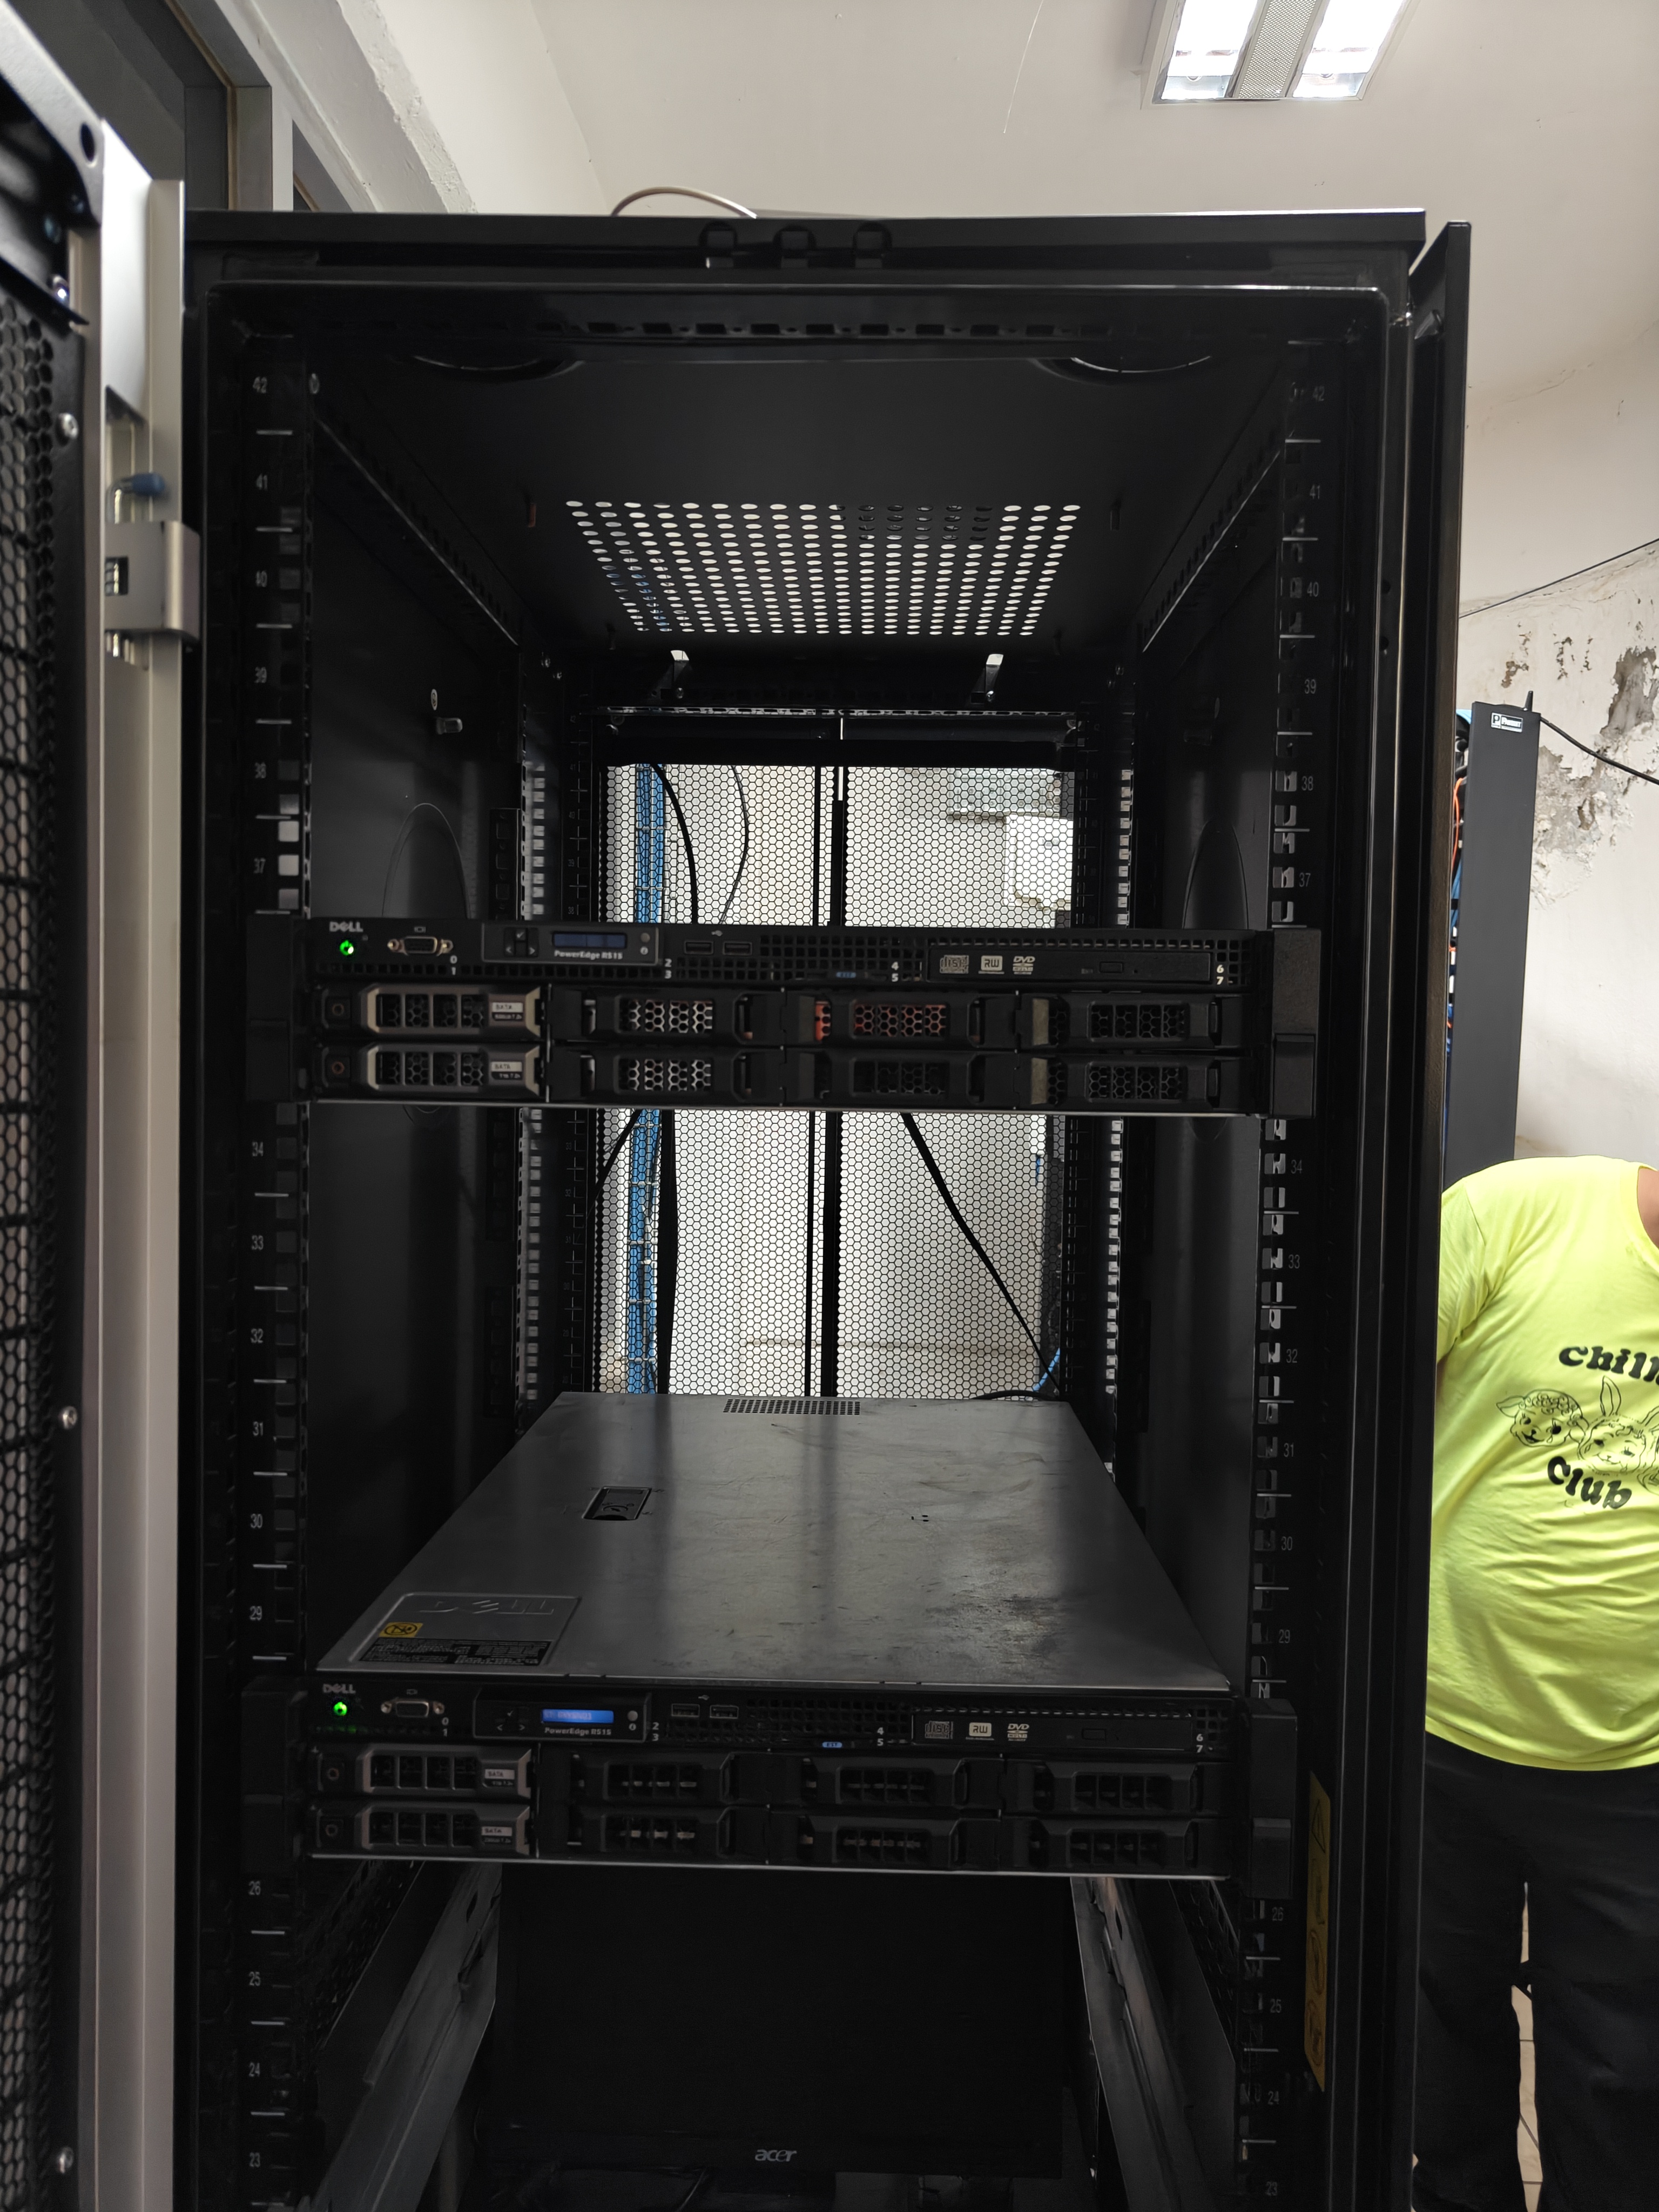
La respuesta fue convertir dos servidores Dell PowerEdge R515 que estaban fuera de uso en un clúster de cálculo científico completo:
- 20 núcleos y 48 GB de RAM, unidos por una red privada dedicada;
- un gestor de colas (Slurm) que reparte el trabajo entre los dos equipos;
- Quantum ESPRESSO 7.5 compilado y optimizado para este hardware;
- acceso por navegador (JupyterHub) desde el campus o desde casa;
- monitoreo en tiempo real (Prometheus + Grafana).
En términos de capacidad medida, el clúster calcula la estructura electrónica completa del silicio en 7.4 segundos. El flujo completo de un nitruro magnético (estructura, bandas por espín, densidad de estados y momentos magnéticos) toma 78 segundos. Las vibraciones de la red de un metal bajo presión toman unas horas por volumen, con cinco volúmenes calculándose a la vez. Es un laboratorio computacional pequeño, pero real, documentado y reproducible.
1. La problemática
1.1 Por qué un laboratorio de energía necesita cómputo
La investigación en energías alternas es, en el fondo, investigación en materiales. La eficiencia de una celda solar depende del gap de su semiconductor. La capacidad de una batería depende de cuántos iones de litio o sodio acepta su cátodo, y a qué voltaje. La producción de hidrógeno depende de qué tan fuerte se adsorbe un átomo de H en la superficie de un catalizador. Todas son preguntas de estructura electrónica, y se pueden responder, total o parcialmente, resolviendo la mecánica cuántica de los electrones del material.
Ese cálculo tiene dos ventajas sobre el laboratorio experimental:
- Explora antes de sintetizar. Se pueden descartar candidatos en una tarde de cómputo en vez de semanas de síntesis.
- Explica lo que se mide. El cálculo muestra qué orbitales forman una banda, dónde se concentra la magnetización o qué vibración vuelve inestable una fase.
1.2 Lo que había antes
| Situación | Consecuencia |
|---|---|
| Cálculos en laptops personales | Se limitaban a sistemas mínimos; el equipo quedaba ocupado horas y un cierre de tapa perdía el trabajo. |
| Software instalado por cada persona, en versiones distintas | Resultados difíciles de reproducir o comparar entre estudiantes. |
Inputs con rutas de otras máquinas (/home/<otro-usuario>/...) | Los archivos no corrían al pasar de una persona a otra. |
| Servidores Dell R515 disponibles pero sin uso | Capacidad de cómputo desaprovechada. |
| Sin acceso remoto organizado | Para calcular había que estar físicamente frente al equipo. |
| Sin forma de ver la carga de los equipos | No se sabía si una máquina estaba ocupada, saturada o libre. |
1.3 Lo que se buscaba
El criterio de diseño fue simplicidad y honestidad con el hardware: usar software libre y estándar en centros de supercómputo (Slurm, OpenMPI, NFS, Quantum ESPRESSO), medir en vez de suponer y documentar cada decisión para que el clúster sobreviva a quien lo instaló.
2. La infraestructura
2.1 Hardware
| omarcito (nodo principal) | caro (nodo de cálculo) | |
|---|---|---|
| Equipo | Dell PowerEdge R515 | Dell PowerEdge R515 |
| Procesadores | 2× AMD Opteron 4130 | 2× AMD Opteron 4180 |
| Núcleos | 8 | 12 |
| Memoria | 24 GB | 24 GB |
| Disco | 196 GB | 393 GB |
| Sistema operativo | Ubuntu Server 24.04 LTS (con Ubuntu Pro) | Ubuntu Server 24.04 LTS (con Ubuntu Pro) |
| Función | Recibe a los usuarios, reparte el trabajo, sirve los archivos | Calcula |
Total: 20 núcleos y 48 GB de RAM. Los nodos no son simétricos. Eso se tomó en cuenta al configurar el reparto de trabajo, porque un cálculo de 12 núcleos solo cabe en caro.
Una restricción importante. Los Opteron 4100 (2010) solo soportan el conjunto de instrucciones base x86-64, sin SSE4 ni AVX. Muchos programas modernos precompilados (por ejemplo, NumPy 2 desde PyPI) abortan con Illegal instruction. Por eso Quantum ESPRESSO se compiló en el propio nodo (
-march=native) y las bibliotecas numéricas de Python vienen de los repositorios de Ubuntu.
2.2 Redes
Cada servidor tiene dos puertos de red, y cada uno cumple una función distinta:
- Red de gestión (eno1): la entrada de los usuarios del campus, la salida a Internet para actualizaciones y los túneles de Cloudflare.
- Red de interconexión (ic0): un cable directo entre los dos servidores, sin switch, con una red privada propia. Por aquí viaja todo el tráfico interno: los archivos compartidos, la comunicación entre procesos de un mismo cálculo y las órdenes del gestor de colas. Así el cálculo no compite con el tráfico del campus y el campus no ve el tráfico del cálculo.
- Sin puertos abiertos a Internet. El acceso externo pasa por túneles de Cloudflare que salen desde los servidores. No hay que abrir puertos en el firewall institucional.
2.3 Capas de software
| Componente | Versión | Para qué sirve |
|---|---|---|
| Quantum ESPRESSO | 7.5, compilado desde fuente | DFT con ondas planas: estructura electrónica, relajación, fonones |
| Slurm | 23.11 | Recibe los trabajos, los pone en cola y los reparte según los núcleos y la memoria libres |
| OpenMPI | 4.1.6 | Divide un cálculo entre varios procesos que se comunican |
| NFS | v4.2 | Cada usuario ve sus archivos igual desde los dos servidores |
| JupyterHub / JupyterLab | 6.0 / 4.6 | Terminal, editor y cuadernos de Python y Julia en el navegador |
| Julia | 1.12.7 | Análisis de resultados en paralelo; paquetes propios precompilados |
| Python + Qiskit | 3.12 / 2.4 | Análisis y simulación de algoritmos cuánticos |
| Prometheus + Grafana | 2.45 / 13.2 | Métricas de CPU, memoria, red, disco, temperatura y cola, por servidor |
2.4 Almacenamiento
/homey/opt/sharedviven en omarcito y caro los monta por la red interna. Un usuario encuentra sus archivos igual en los dos servidores, sin copiar nada./tmpes local en cada servidor y es donde los cálculos escriben sus archivos de trabajo. Se midió que escribirlos en/home(por la red) hacía que el mismo cálculo tardara el doble en caro: 15.2 s contra 7.4 s.
3. El funcionamiento
3.1 La idea central: una cola de trabajos
Nadie ejecuta los cálculos «a mano» en los servidores. El investigador describe qué quiere calcular y cuántos recursos necesita, y lo entrega a Slurm. Slurm espera a que esos recursos estén libres, ejecuta el cálculo en el servidor adecuado y guarda el resultado. Las ventajas son tres:
- Nadie se estorba. Dos cálculos nunca pelean por los mismos núcleos.
- El trabajo sobrevive. Se puede cerrar la laptop, el navegador o la sesión: el cálculo sigue.
- El clúster se llena solo. Si hay cinco cálculos pendientes, Slurm los acomoda en los huecos libres de los dos servidores.
3.2 El ciclo de vida de un cálculo
3.3 Las cuatro formas de trabajar
| Patrón | Cuándo usarlo | Ejemplo medido |
|---|---|---|
| Un cálculo en un servidor | Casi siempre: un nodo le gana a dos en casos pequeños y medianos | Si: SCF + bandas en 7.4 s (caro, 12 núcleos) |
| Job array (muchos cálculos iguales con un parámetro distinto) | Convergencia, ecuaciones de estado, barridos de presión, fonones por volumen | 5 cálculos simultáneos (2 en omarcito y 3 en caro) |
| Tareas independientes en los dos nodos | Programas en Python o Julia que procesan una lista | 100 elementos repartidos: 60 en caro y 40 en omarcito |
| Cadena de dependencias | SCF → bandas → DOS → análisis, cada paso al terminar el anterior | Flujo completo de CrN en un solo trabajo, 78.5 s |
Las cuatro tienen plantillas probadas en /opt/shared/examples/ y una guía en docs/trabajos-batch.md.
3.4 Cómo se reparte la memoria
Cada núcleo pedido recibe por defecto 1.8 GB de memoria. El ajuste se hizo el 29 de septiembre de 2026, después de detectar que, sin él, un solo trabajo pequeño reservaba la memoria completa de un servidor y bloqueaba a todos los demás aunque sobraran núcleos. Hoy cinco trabajos de 4 núcleos caben a la vez y los 20 núcleos se aprovechan.
3.5 Monitoreo
El tablero «Clúster unext» muestra, para cada servidor por separado o lado a lado:
- uso de CPU, total y por núcleo;
- memoria y carga;
- red interna y de gestión;
- tráfico de archivos compartidos;
- temperatura;
- núcleos asignados por Slurm y trabajos en cola.
Con él se puede saber en segundos si un cálculo está usando lo que pidió, si un servidor está ocioso o si alguien está escribiendo archivos pesados por la red.
4. El uso en energías alternas
4.1 Del problema energético a la propiedad calculable
| Área | Pregunta típica | Qué entrega el clúster |
|---|---|---|
| Fotovoltaica | ¿Qué tan bien absorbe la luz solar este semiconductor? ¿El gap es directo o indirecto? | Estructura de bandas, densidad de estados, carácter orbital de las bandas |
| Baterías | ¿A qué voltaje se inserta el litio en este cátodo? ¿Se deforma la estructura? | Energías totales de fases litiadas y deslitiadas, relajación de celda y posiciones |
| Hidrógeno y catálisis | ¿El H se adsorbe muy fuerte, muy débil o en el punto justo? | Energías de adsorción, PDOS de la superficie, centro de la banda d |
| Termoelectricidad y gestión térmica | ¿Cómo vibra la red? ¿Cómo cambia el volumen con la temperatura? | Dispersión de fonones, parámetros de Grüneisen, dilatación térmica cuasi-armónica |
| Recubrimientos y magnetismo | ¿Qué tan rígido es? ¿Es magnético y dónde está el momento? | Ecuación de estado, módulo de compresibilidad, momentos por átomo y orbital, polarización de espín |
| Materiales bajo presión | ¿A qué presión cambia de fase? | Entalpías de las fases, presión de transición, inestabilidades vibracionales |
4.2 Lo que ya se hizo en el clúster
Los primeros cálculos sirven a la vez de validación del clúster y de demostración de sus capacidades:
| Estudio | Resultado | Comparación con el experimento |
|---|---|---|
| Silicio: estructura de bandas (base de la fotovoltaica) | Gap indirecto con el mínimo de conducción en Γ→X; ancho de valencia de 12.1 eV | Forma correcta; el gap PBE (0.54 eV) subestima el real (1.17 eV), como se espera del funcional |
| Silicio: ecuación de estado | a₀ = 5.470 Å, B₀ = 89 GPa | Experimento: 5.431 Å y ≈ 98 GPa |
| Silicio: transición a β-Sn bajo presión, con fonones | 9.0 GPa a 0 K, 8.8 GPa a 300 K; modo blando que desestabiliza β-Sn hacia ~18 GPa | Experimento: 10–12.5 GPa |
| Silicio: fonones y dilatación térmica | Fonones a 2–5 % de los datos de neutrones; dilatación negativa por debajo de ~118 K (mínimo de −0.53×10⁻⁶ K⁻¹) | Experimento: mínimo de ≈ −0.5×10⁻⁶ K⁻¹, cambio de signo hacia 120 K |
| Nitruro de cromo (CrN) zinc-blenda | Metal ferromagnético, 2.0 μB por celda (Cr-3d: 2.1 μB), polarización de espín de 18.6 % en E_F | Flujo completo en 78.5 s |
4.3 Investigación en cómputo cuántico
El clúster también sostiene una línea de tesis que compara la simulación clásica (DFT en el clúster) con algoritmos cuánticos (VQD y SSVQE) para la estructura de bandas del silicio. Los algoritmos cuánticos se simulan en los mismos servidores, repartidos en los dos nodos, y quedan listos para ejecutarse en procesadores cuánticos de IBM.
Conclusión medida: hoy el cómputo clásico es órdenes de magnitud más rápido y más completo para este tipo de problema. Aun así, el laboratorio ya tiene un flujo validado (modelo físico → qubits → algoritmo → hardware) para cuando las máquinas cuánticas lo justifiquen.
5. Cómo se usa (vista del investigador)
- Entrar por el navegador (JupyterHub) o por terminal (SSH).
- Preparar el input en una carpeta propia, con pseudopotenciales de
/opt/shared/pseudo. - Converger los parámetros con un job array antes de los cálculos de producción.
- Enviar con
sbatcha partir de una plantilla. - Verificar en la salida que convergió, que la celda está en equilibrio y que la magnetización es estable.
- Analizar y graficar en Jupyter, y descargar a la computadora personal si hace falta.
La documentación de usuario está escrita para alguien que nunca ha usado un clúster: docs/empezar-aqui.md (también en PDF).
6. Acceso y seguridad
El modelo de seguridad parte de una regla: ningún servicio queda expuesto directamente a Internet.
| Vía | Desde | Cómo se autentica |
|---|---|---|
| JupyterHub en la LAN | Campus | Cuenta del sistema del usuario |
| JupyterHub público | Fuera del campus | Cuenta del sistema (está pendiente agregar Cloudflare Access) |
| SSH por túnel | Fuera del campus | Llave SSH + túnel de Cloudflare |
| SSH directo | Campus | Cuenta del sistema o llave |
| Grafana | Fuera del campus | Cloudflare Access (correo autorizado) + usuario de Grafana |
Principios aplicados:
- Las credenciales no viven en los repositorios. La contraseña de administración de Grafana se generó en el servidor y solo es legible por root. Los archivos de credenciales locales están excluidos del control de versiones.
- Mínimo privilegio en la red. El monitoreo solo escucha en localhost o en la red interna, y el firewall bloquea esos puertos hacia el campus.
- Actualizaciones de seguridad. Ambos servidores tienen Ubuntu Pro (ESM), que cubre también los paquetes de monitoreo.
- Cuentas homogéneas. Cada usuario tiene el mismo identificador en los dos servidores, y un script (
add-cluster-user.sh) da de alta cuentas de forma consistente.
Nota operativa: dentro del campus, el firewall institucional puede interceptar la conexión TLS del túnel (error de certificado). En ese caso se usa la conexión directa por la red local.
7. Resultados de la puesta en marcha
| Indicador | Valor |
|---|---|
| Capacidad | 20 núcleos, 48 GB de RAM, 2 servidores |
| Disponibilidad de software | QE 7.5 (pw, pp, PHonon), Julia, Python, Qiskit, JupyterHub |
| Validación de QE | Energía del Si idéntica (−22.83847650 Ry) con 1, 8, 12, 16 y 20 procesos |
| Cálculo de bandas de Si | 7.4 s |
| Flujo electrónico y magnético completo de CrN | 78.5 s |
| Fonones de un metal (β-Sn) por volumen | ~2.7 h con 4 núcleos, 5 volúmenes en paralelo |
| Trabajos simultáneos | Hasta 5 (de 4 núcleos), repartidos automáticamente |
| Visibilidad | Tableros en tiempo real por servidor y de la cola |
| Documentación | 12 documentos, plantillas probadas, historial de cambios y control de versiones (git) |
8. Limitaciones y hoja de ruta
8.1 Limitaciones actuales
- Procesadores de 2010. Son suficientes para sistemas de decenas de átomos, pero no para celdas grandes (cientos de átomos) ni para funcionales híbridos costosos. No admiten software moderno precompilado con instrucciones AVX.
- Red de 1 Gb/s entre nodos. Basta para repartir muchos cálculos independientes, pero limita que un solo cálculo grande escale a los dos servidores.
- Sin GPU. Los códigos modernos (QE, VASP) aceleran de 4 a 10 veces en GPU.
- Programas de QE no compilados todavía: NEB (barreras de difusión, clave para baterías), HP (U de Hubbard autoconsistente) y EPW (acoplamiento electrón-fonón).
- Biblioteca de pseudopotenciales mínima: Si, Cr y N. Los demás elementos se agregan según se necesiten.
8.2 Hoja de ruta
9. Documentación relacionada
| Documento | Para quién |
|---|---|
docs/empezar-aqui.md | Usuarios nuevos: el primer cálculo en cinco minutos |
docs/guia-usuario.md | Usuarios: flujo de trabajo y elección de recursos |
docs/trabajos-batch.md | Usuarios avanzados: job arrays, los dos nodos, Julia, dependencias |
docs/quantum-espresso.md | Compilación, pseudopotenciales, rendimiento de QE |
docs/README.md | Arquitectura técnica detallada |
docs/operacion.md | Administradores: servicios, fallas, cambios de configuración |
docs/monitoreo.md | Administradores: Prometheus y Grafana |
docs/usuarios.md | Administradores: altas y bajas de cuentas |
docs/changelog.md | Historial de todo lo que se hizo |
El Laboratorio de Energías Alternas convirtió hardware en desuso en una plataforma de simulación de materiales operativa, medida y documentada. El valor no está solo en los 20 núcleos: está en que cualquier investigador del laboratorio puede, desde su navegador, plantear una pregunta sobre un material para energía y obtener una respuesta reproducible.